Suprminer把NEB优化带到AMD,并扩大RTX显存结果表
来源发布日期: 2026-11-21 · 编辑分析发布日期: 2026-11-21
1.9.49新增AMD OpenCL路径,1.9.50压缩RTX表格并修复HiveOS日志;短时固定模型的大倍率不等于长期付款表现。
AMD也能使用较快的NEB方法
Suprminer1.9.49于11月20日UTC18时10分发布,把NEB低成本尝试选择带到AMD OpenCL。1.9.50于21日UTC02时50分跟进,扩大RTX结果表容量,并修复HiveOS日志位置。昨天仅针对NVIDIA的优化,如今扩展到另一组用户,最新版本保留1.9.49加入的AMD计算。这是新增设备路径与资源使用方式的变化,不只是给同一组旧成绩换上新版本号,用户应分别看两个版本真正改变的部分。
NEB是Neural Engine Byte,采用proof-of-training,每次挖矿尝试对16个样本执行精确整数训练步骤。不同尝试的计算成本并不相同,软件为当前训练模型选择便宜尝试,精确验证,只统计实际执行的工作。没有启动的昂贵尝试不会算作已经完成,也没有因此改变比特币ASIC挖矿。了解这个机制,可以区分选择方法提升吞吐量与放松验证要求,两者不是同一回事,不能把新路径解释成提交未经计算的工作。
三款AMD设备有成对结果
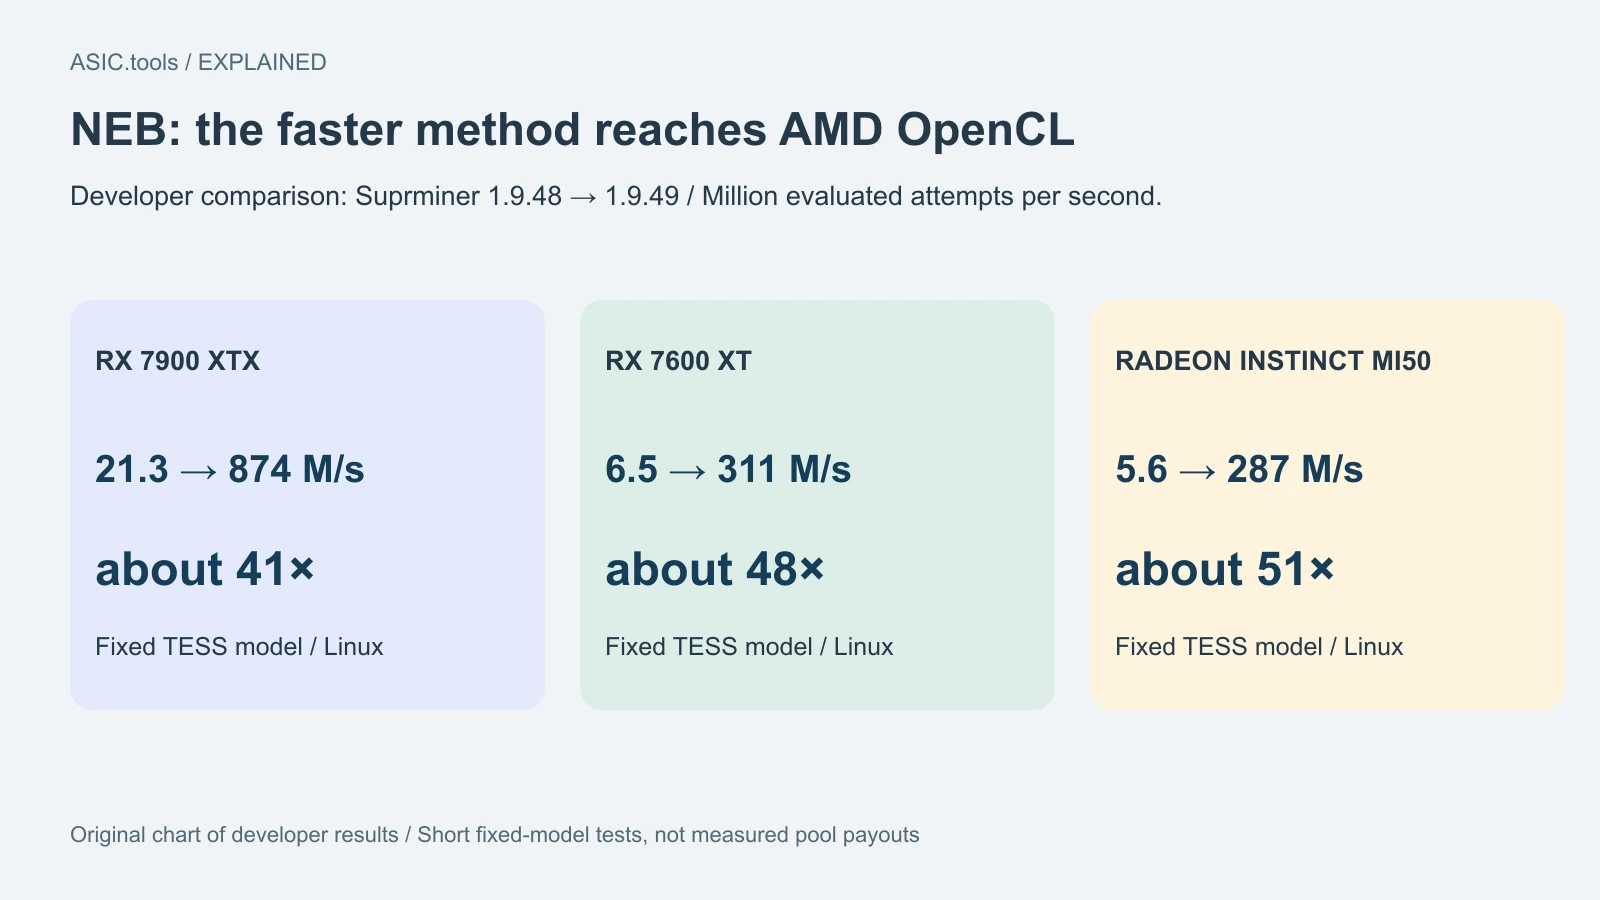
开发者Linux对比中,RX7900XTX在Kepler上从每秒2100万次执行尝试提升到9760万次,TESS从2130万到8.74亿次。RX7600XT分别从610万到2980万,以及650万到3.11亿次。Radeon Instinct MI50则从510万到1990万,以及560万到2.87亿次。每一组都应保留模型名称和前后版本,不能把同一张卡在Kepler与TESS上的不同速度当成同一种工作直接相加比较。
TESS对应约41倍、48倍及51倍,但只针对这些固定训练模型和测试条件,不是已经测量的钱包付款,也不保证每个未来区块同样提升。发布说明称,最终程序在RX7900XTX与RX7600XT上重现速度,并未声称所有AMD代际都完成硬件验证。对没有列出的显卡,存在OpenCL软件包不等于有相同的测量结果;报道保留设备范围,是为了让拥有不同卡的读者知道哪些数字确实属于自己的硬件类别。
短时运行不等于长期稳定速度
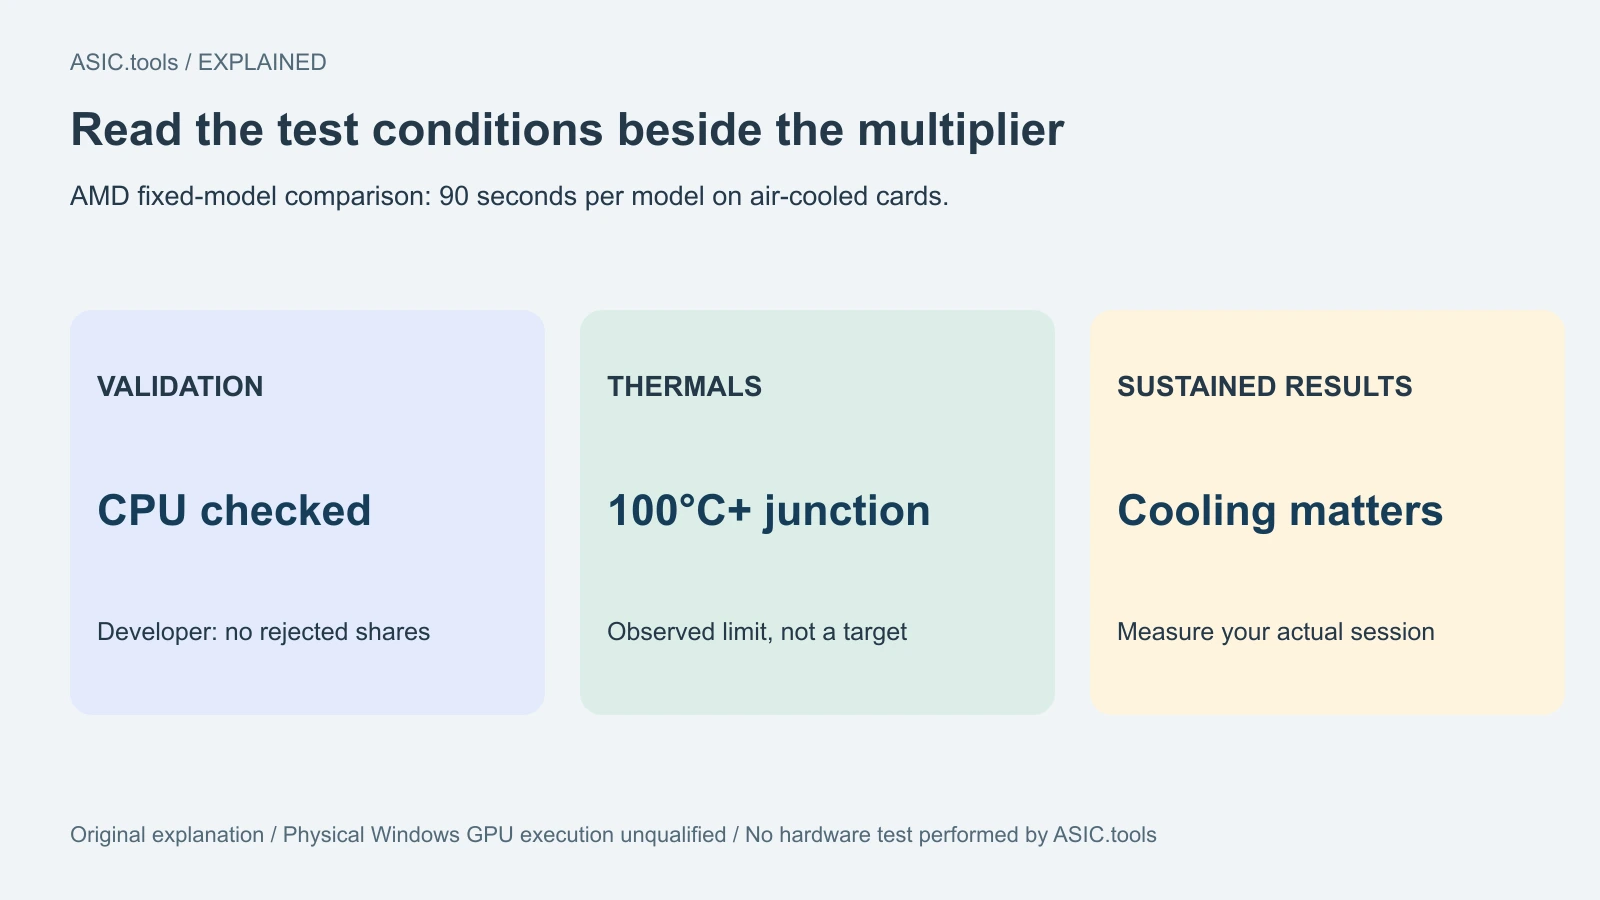
AMD对比在11月20日进行,使用主网19日的模型、相同工作和频率设置,每个模型运行90秒。开发者表示,风冷测试卡触及温度限制,结温达到100摄氏度或以上,因此持续表现取决于冷却条件。结温是芯片内部热点一类的温度读数,不等于房间温度。这里报告的是测试遇到的限制,不是建议用户把设备调整到同样温度,更不能从短时最高速度推断全天不会降频的产出。
按开发者说明,所有返回工作通过CPU参考核对,没有被拒绝。AMD新路径在模型变化时与旧内核对照,仅在更快时启用,当前模型的表格最多需要约0.6GB显存。NEB_DISABLE_NONCE_SELECTION=1可恢复此前行为。这些检查与回退选项帮助解释软件如何选择路径,但用户仍要核对实际接受工作和运行日志,不能仅因控制台显示新版本,就认为每个任务必然采用同样的方法或得到同样的提升。
最新RTX版本占用更多空闲显存
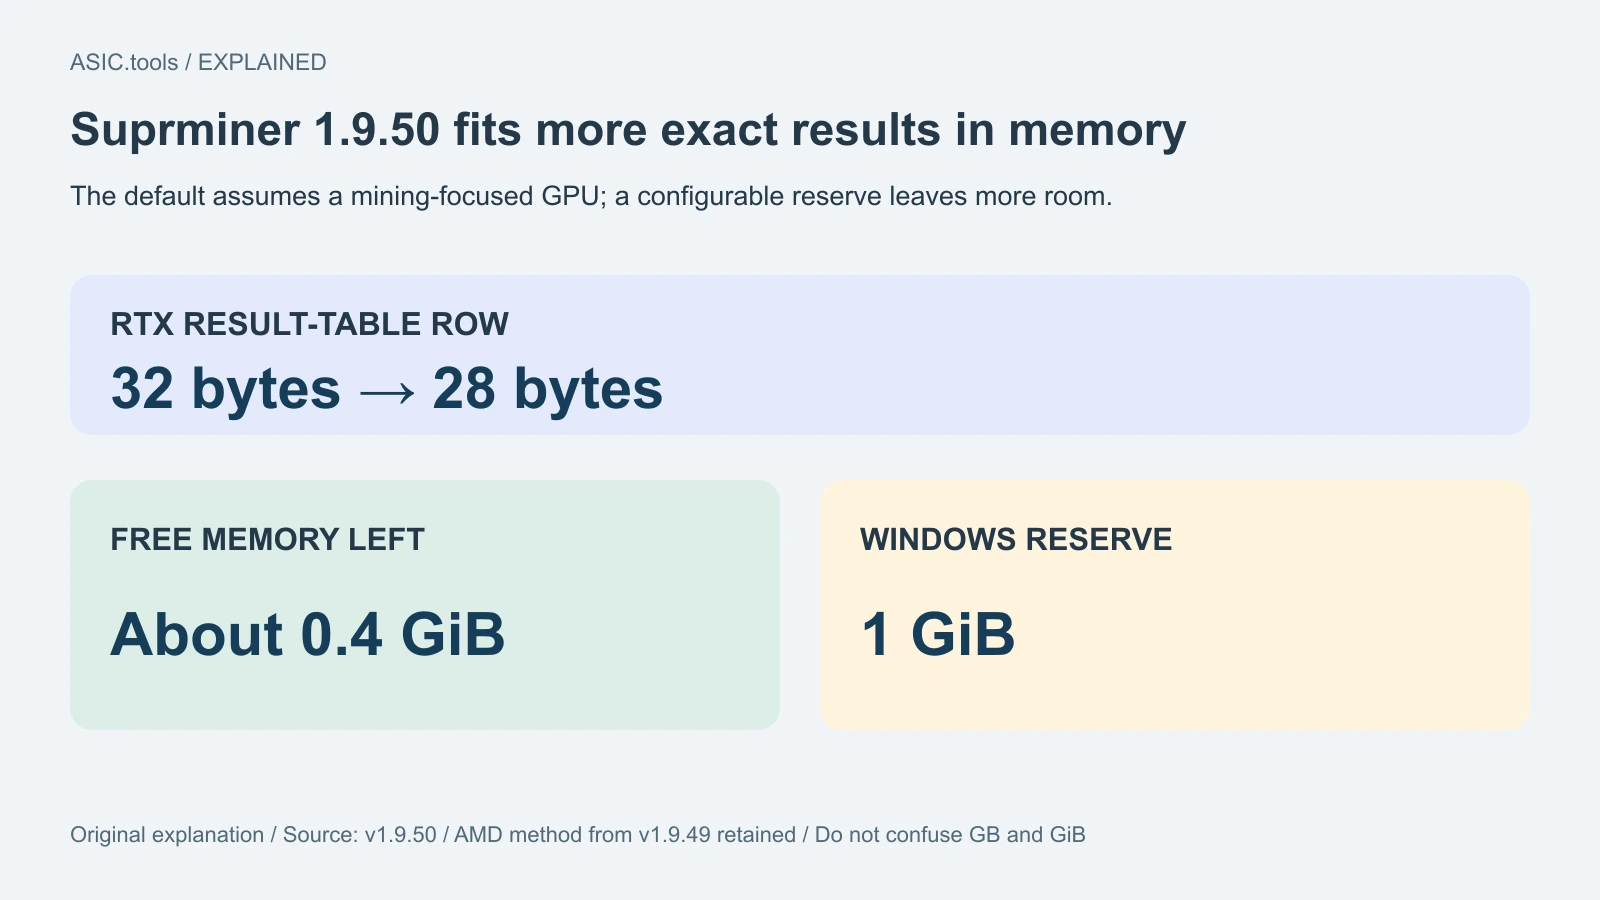
1.9.50把结果表每行从32字节压缩到28字节,并只留下约0.4GiB空闲显存,Windows留下1GiB。GiB是按二进制计数的内存单位;保留的空间与表格自身容量不是同一个数字。显存中放入更多精确结果,就能让更多尝试直接从表中得到答案。开发者提醒NEB挖矿期间不要在同一显卡上运行其他程序,因为默认表格会使用空闲内存,这对同时承担桌面或其他计算任务的显卡尤其有实际影响。
用户可用NEB_TRIPLE_RESERVE_MB增加保留空间,用NEB_TRIPLE_TABLE_GB限制大表,或者关闭它。固定模型测试里,RTX5090的TESS较1.9.49约快5%,5080约快8.9%,3070约快6.4%;Kepler在5090和3070上基本不变。这是另一组前后比较,不是AMD的大倍率,也不应与昨天1.9.48的不同基线拼接。选择合适保留量,是内存分配决定,不是把较大的表格数字直接当作固定收益保证。
算法、费用与日志的变化范围
算法参数仍是neb,矿工软件费保持0%,矿池费用另算,其他算法没有改变。两次发布都保留精确验证,不使用浮点近似。表格在Kepler和TESS区块交替时继续保留,只更新模型发生变化的位置,避免不必要的完整重建。这说明性能优化包括模型切换时的资源管理,不只是某一时刻的计算速度;比较运行时,应同时留意切换过程和真实被接受的工作,而不是只截取一个瞬间读数。
最新版还把日志写到HiveOS实际读取的文件,使常用miner log视图能够正常提供信息。发布提供Linux、Windows、HiveOS、mmpOS、SMOS和Docker包,分NVIDIA与AMD版本。说明仍把物理Windows显卡运行列为未完成验证范围,因此有压缩包不等于完成了这项硬件测试。对用户来说,系统包、显卡后端与验证范围都需要对应,不能把Linux设备的结果直接视为Windows上已经测得的同一表现。
用实际时段比较,而不是只看倍率
AMD矿机首先应检查受支持的OpenCL路径是否生效,并产生被接受的工作。与其他任务共用的RTX,则要核对显存保留是否足够,因为默认设置更偏向专门挖矿的GPU。可在同一时段对照官方软件包、当前模型速度、接受贡献、温度和真实电量。这样才能把软件显示与运行记录放在一起理解,既不会只看高倍率,也能发现设备是否因内存或冷却条件而没有保持测试中的状态。
三张原创图分别展示AMD比较、最新显存策略与短时测试边界。版本说明和当前设置文档已经保留,但我们没有安装这些程序或独立重做测试。这是软件支持范围扩展及资源分配更新,不是收入实测或购买某款卡的建议。读者可以依据自己已有设备核对变化,再以实际接受工作和成本评估结果;新闻中的固定模型对比,不能取代未来网络模型、矿池记账和设备运行条件共同决定的真实表现。
来源: Suprminer ↗ · AMD support: Suprminer 1.9.49, November 20 ↗ · Current methodology and setup ↗
挖矿计算器 ↗